
Kimi K3发布,2.8 万亿,全球最大开源模型,这次是真·掀桌子
2.8 万亿参数、100 万 Token 上下文、14 项测试中 11 项超越 GPT-5.6 Sol——Kimi K3 一发布就把服务器逼到承载极限。全球最大开源模型是真正掀桌,还是算力昂贵的巨兽?答案藏在性能、成本和部署门槛里。
捕捉 AI 模型、开源生态与产业变化。官网提供内容摘要、来源与发布日期,阅读全文可继续前往“橙子AI科技”微信公众号原文。
2.8 万亿参数、100 万 Token 上下文、14 项测试中 11 项超越 GPT-5.6 Sol——Kimi K3 一发布就把服务器逼到承载极限。全球最大开源模型是真正掀桌,还是算力昂贵的巨兽?答案藏在性能、成本和部署门槛里。
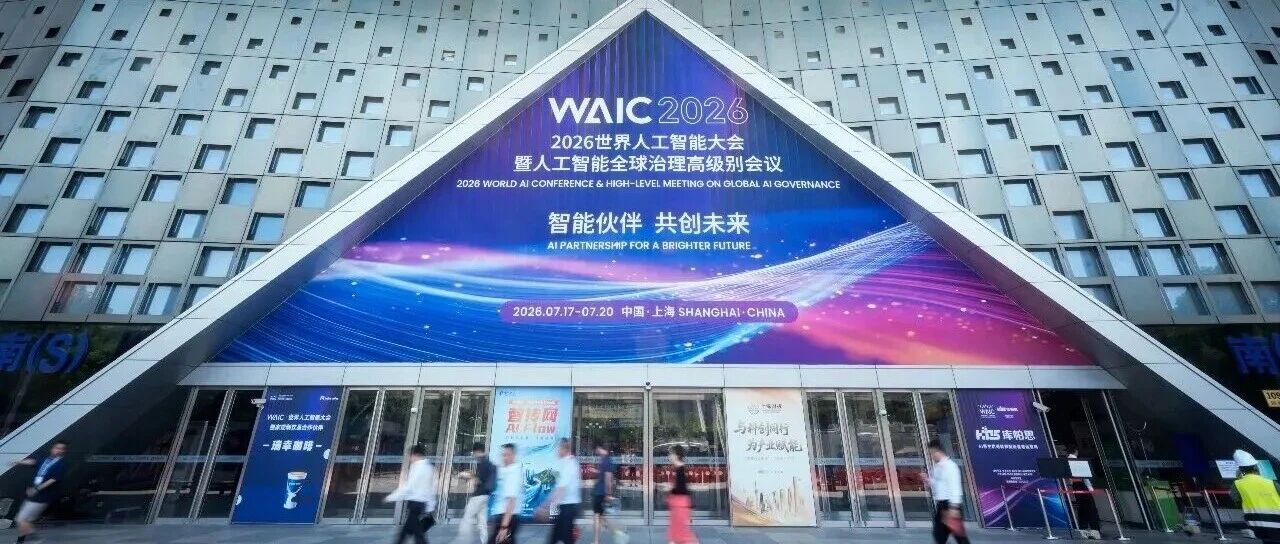
“开源开放”被直接点名,AI 普惠从口号走向行动坐标。WAIC 2026 释放了哪些关键信号?模型能不能拿到、数据能不能合规使用、核心技术能不能自主掌握,将决定下一阶段中国 AI 的速度与底气。
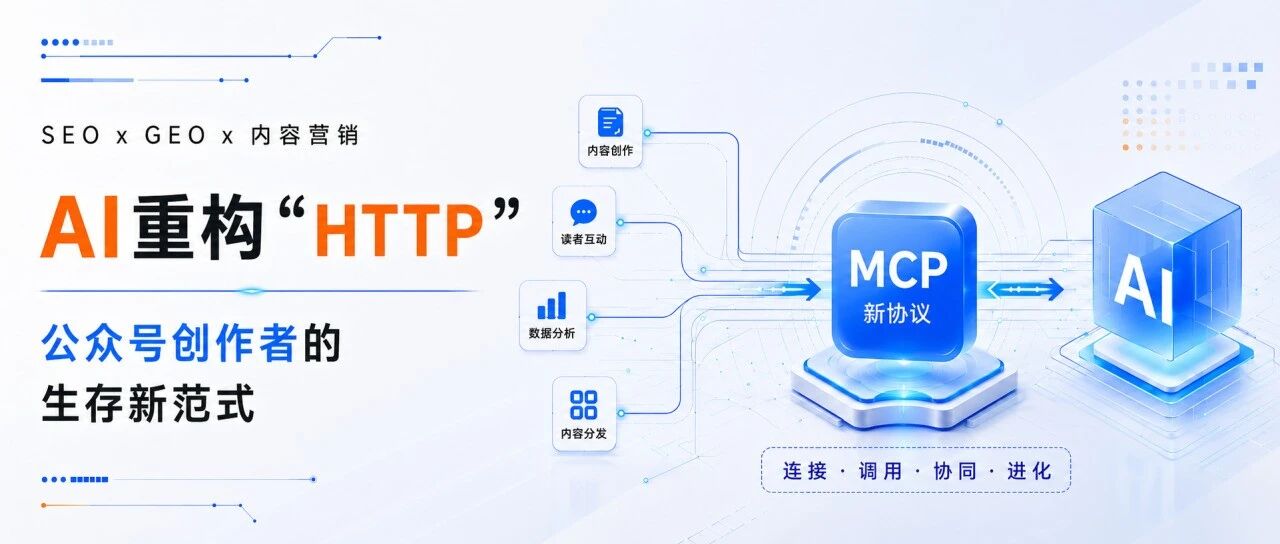
流量规则正在换代:SEO 让人找到你,GEO 让 AI 引用你,MCP 则让 AI 直接调用你。只顾在公众号发稿,内容可能永远困在围墙里;下一轮竞争,拼的是谁先进入 AI 的答案和供应商名单。
DeepSeek 不满足于做模型,下一步可能把手伸进芯片。若推理芯片真的落地,它争夺的将不只是成本,而是算力供应链和每一个 Token 的底层控制权——这场仗将直面英伟达、华为与全球芯片巨头。
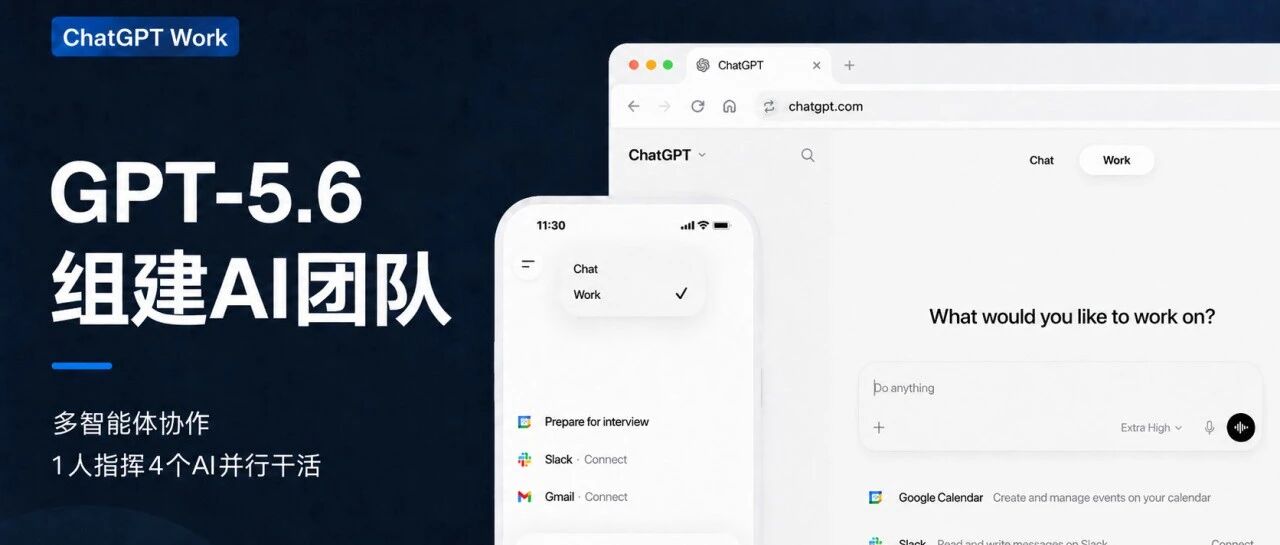
一个人发号施令,4 个 AI 同时研究、执行、检查、汇报——GPT-5.6 把聊天机器人直接升级成“数字员工团队”。效率可能暴涨,但权限、审批、审计和回滚跟不上,AI 团队也可能把错误放大四倍。
跑分冲上第一,真实口碑却突然翻车:更贵、更“轴”、旧提示词失效,长上下文表现也被质疑。Claude Opus 4.7 到底是最强模型,还是一场代价高昂的公测?升级前这几处坑必须看清。
不是写几段代码,而是连续自主工作 8 小时:规划、执行、测试、修复一路闭环,甚至完成数百轮性能优化。GLM-5.1 正把 Coding Agent 从“代码生成器”推向真正能扛复杂工程的 AI 员工。
手机也能跑、256K 长上下文、图像视频一起看,还首次把可商用开源摆上桌——Gemma 4 试图把顶级多模态能力塞进普通设备。它真能逼近 GPT-4o,还是新一轮跑分狂欢?
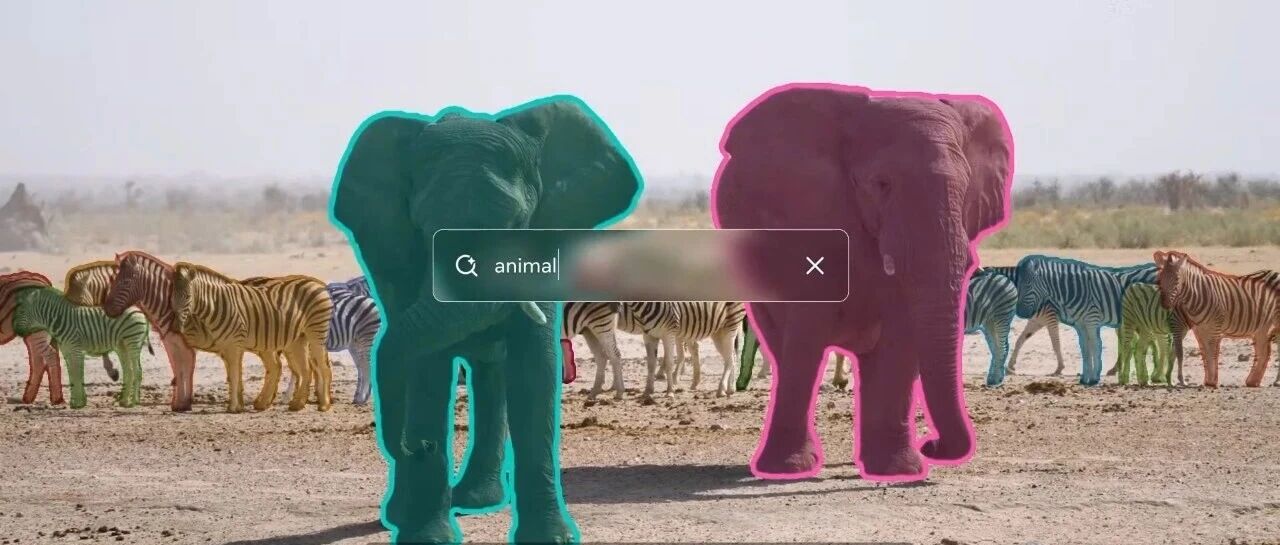
一次推理同时盯住最多 16 个目标,视频跟踪速度冲到 32 FPS——SAM 3.1 把“逐个计算”变成“一次搞定”。更快、更省显存、更接近实时,短视频特效、AR、电商和机器人视觉的门槛可能就此被拉低。